
Von der Datei zum Vorgang: was die KI aus einem Eingang herausliest
Ein Dokument zu erkennen ist die halbe Arbeit. Die andere Hälfte ist die Frage, was daraus folgt: Wer muss etwas tun, bis wann, und gehört das überhaupt zu einem Fall, der schon läuft? Genau dort setzt die Analyse in V.L.E.X.A Inbound an.
Erst die Einordnung
Jeder Eingang bekommt einen Dokumenttyp, etwa Rechnung, Mahnung, Kündigung, Bescheid oder Schadensmeldung. Welche Typen es gibt, entscheidet nicht der Hersteller, sondern Sie: Eigene Kategorien legen Sie per Klick an, und das Modell arbeitet ab diesem Moment damit. Filter, Zuweisungsregeln und geführte Prozesse finden die neue Kategorie sofort mit.
Dann die Felder
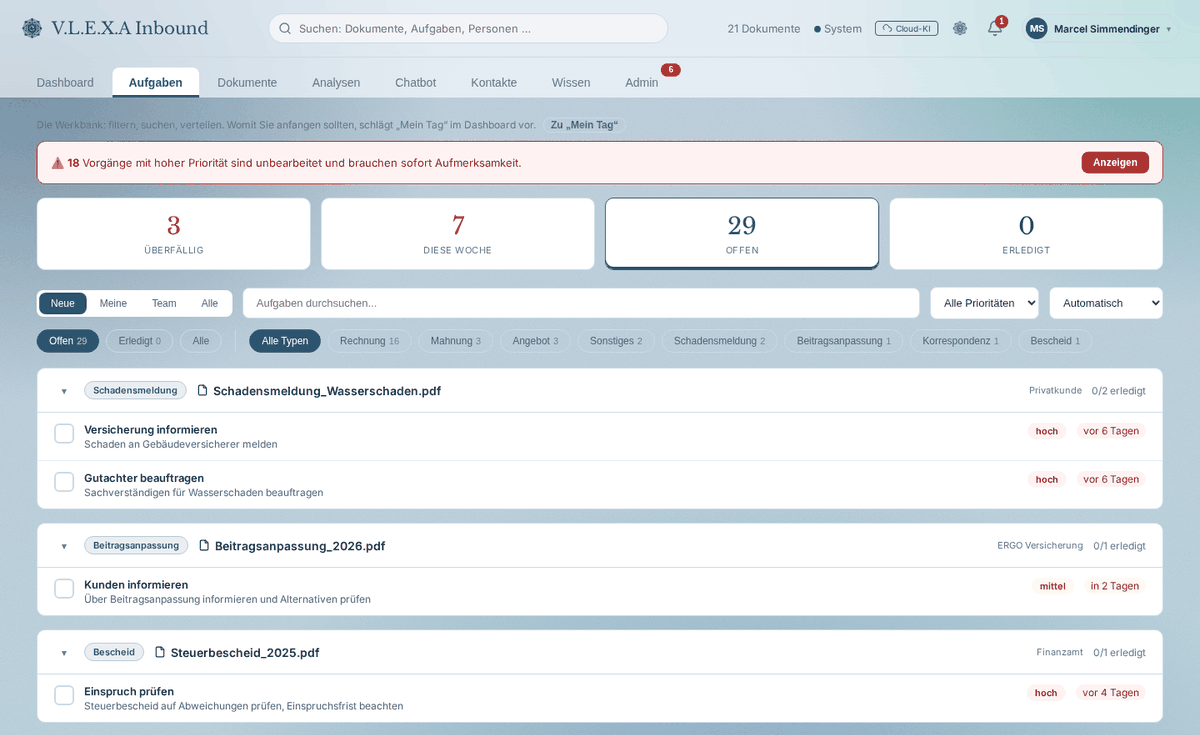
Aus dem Fließtext wird eine saubere Liste: Beträge, Fristen und Fälligkeiten, Vertrags-, Schaden- und Kundennummern, Absender, Betreff. Aus diesen Angaben entstehen konkrete Aufgaben mit Frist und Priorität, und das System stuft ein, was liegen bleiben darf und was nicht. Lange Dokumente sind dabei kein Sonderfall, fünfzig Seiten und mehr laufen ganz normal durch.

Aus jedem Eingang entstehen Aufgaben mit Frist und Priorität, gebündelt am zugehörigen Vorgang.
Und dann die Vorsichtsmaßnahmen
Ein Sprachmodell, das raten darf, ist im Posteingang gefährlich. Deshalb bekommt es hier wenig Spielraum. Wo sich etwas ausrechnen lässt, wird gerechnet und nicht geschätzt. Was sich nicht sicher belegen lässt, wird als unsicher markiert und geht in die Prüfung, statt automatisch durchzulaufen. Ein leeres Feld mit Hinweis ist uns lieber als ein plausibel gefülltes.
Ein Fall, nicht drei Dokumente
Zuletzt die Zuordnung. Kommt zur selben Sache erst ein Brief, dann eine E-Mail und später ein Anruf, sind das für unsere Engine V.L.E.X.A BEI drei Nachrichten zu einem Vorgang und nicht drei zusammenhanglose Dokumente. Trifft dieselbe Nachricht versehentlich zweimal ein, wird das erkannt, statt einen zweiten Fall anzulegen. Genau dieses doppelte und falsche Zuordnen war vorher die häufigste Fehlerquelle von Hand.